你见过会“复盘”的机器人吗?不是那种录个视频回放一下,而是真能一边干、一边想:‘刚才杯子没放稳,是不是因为碗刚被挪过,视野偏了?下次得先校准摄像头再伸手。’北京交大、北大、NYU、USC和灵行智能联合搞出的Recursia,就是这么个玩意儿。它不喂新数据、不调超参数、不上新模型——就靠自己在真机上反复试错,把失败变成经验,再把经验编进下一轮动作里。最硬核的一幕:机械臂先把碗放到盘子上,再抓起杯子塞进那个‘刚被移动过的碗’里。人类觉得稀松平常,可对多数机器人来说,第二步的世界已经变了——碗的位置、自身姿态、视觉遮挡全都不一样了。OpenVLA这类热门模型在这类任务上直接挂零,而Recursia真机跑下来,成功率冲到100%。
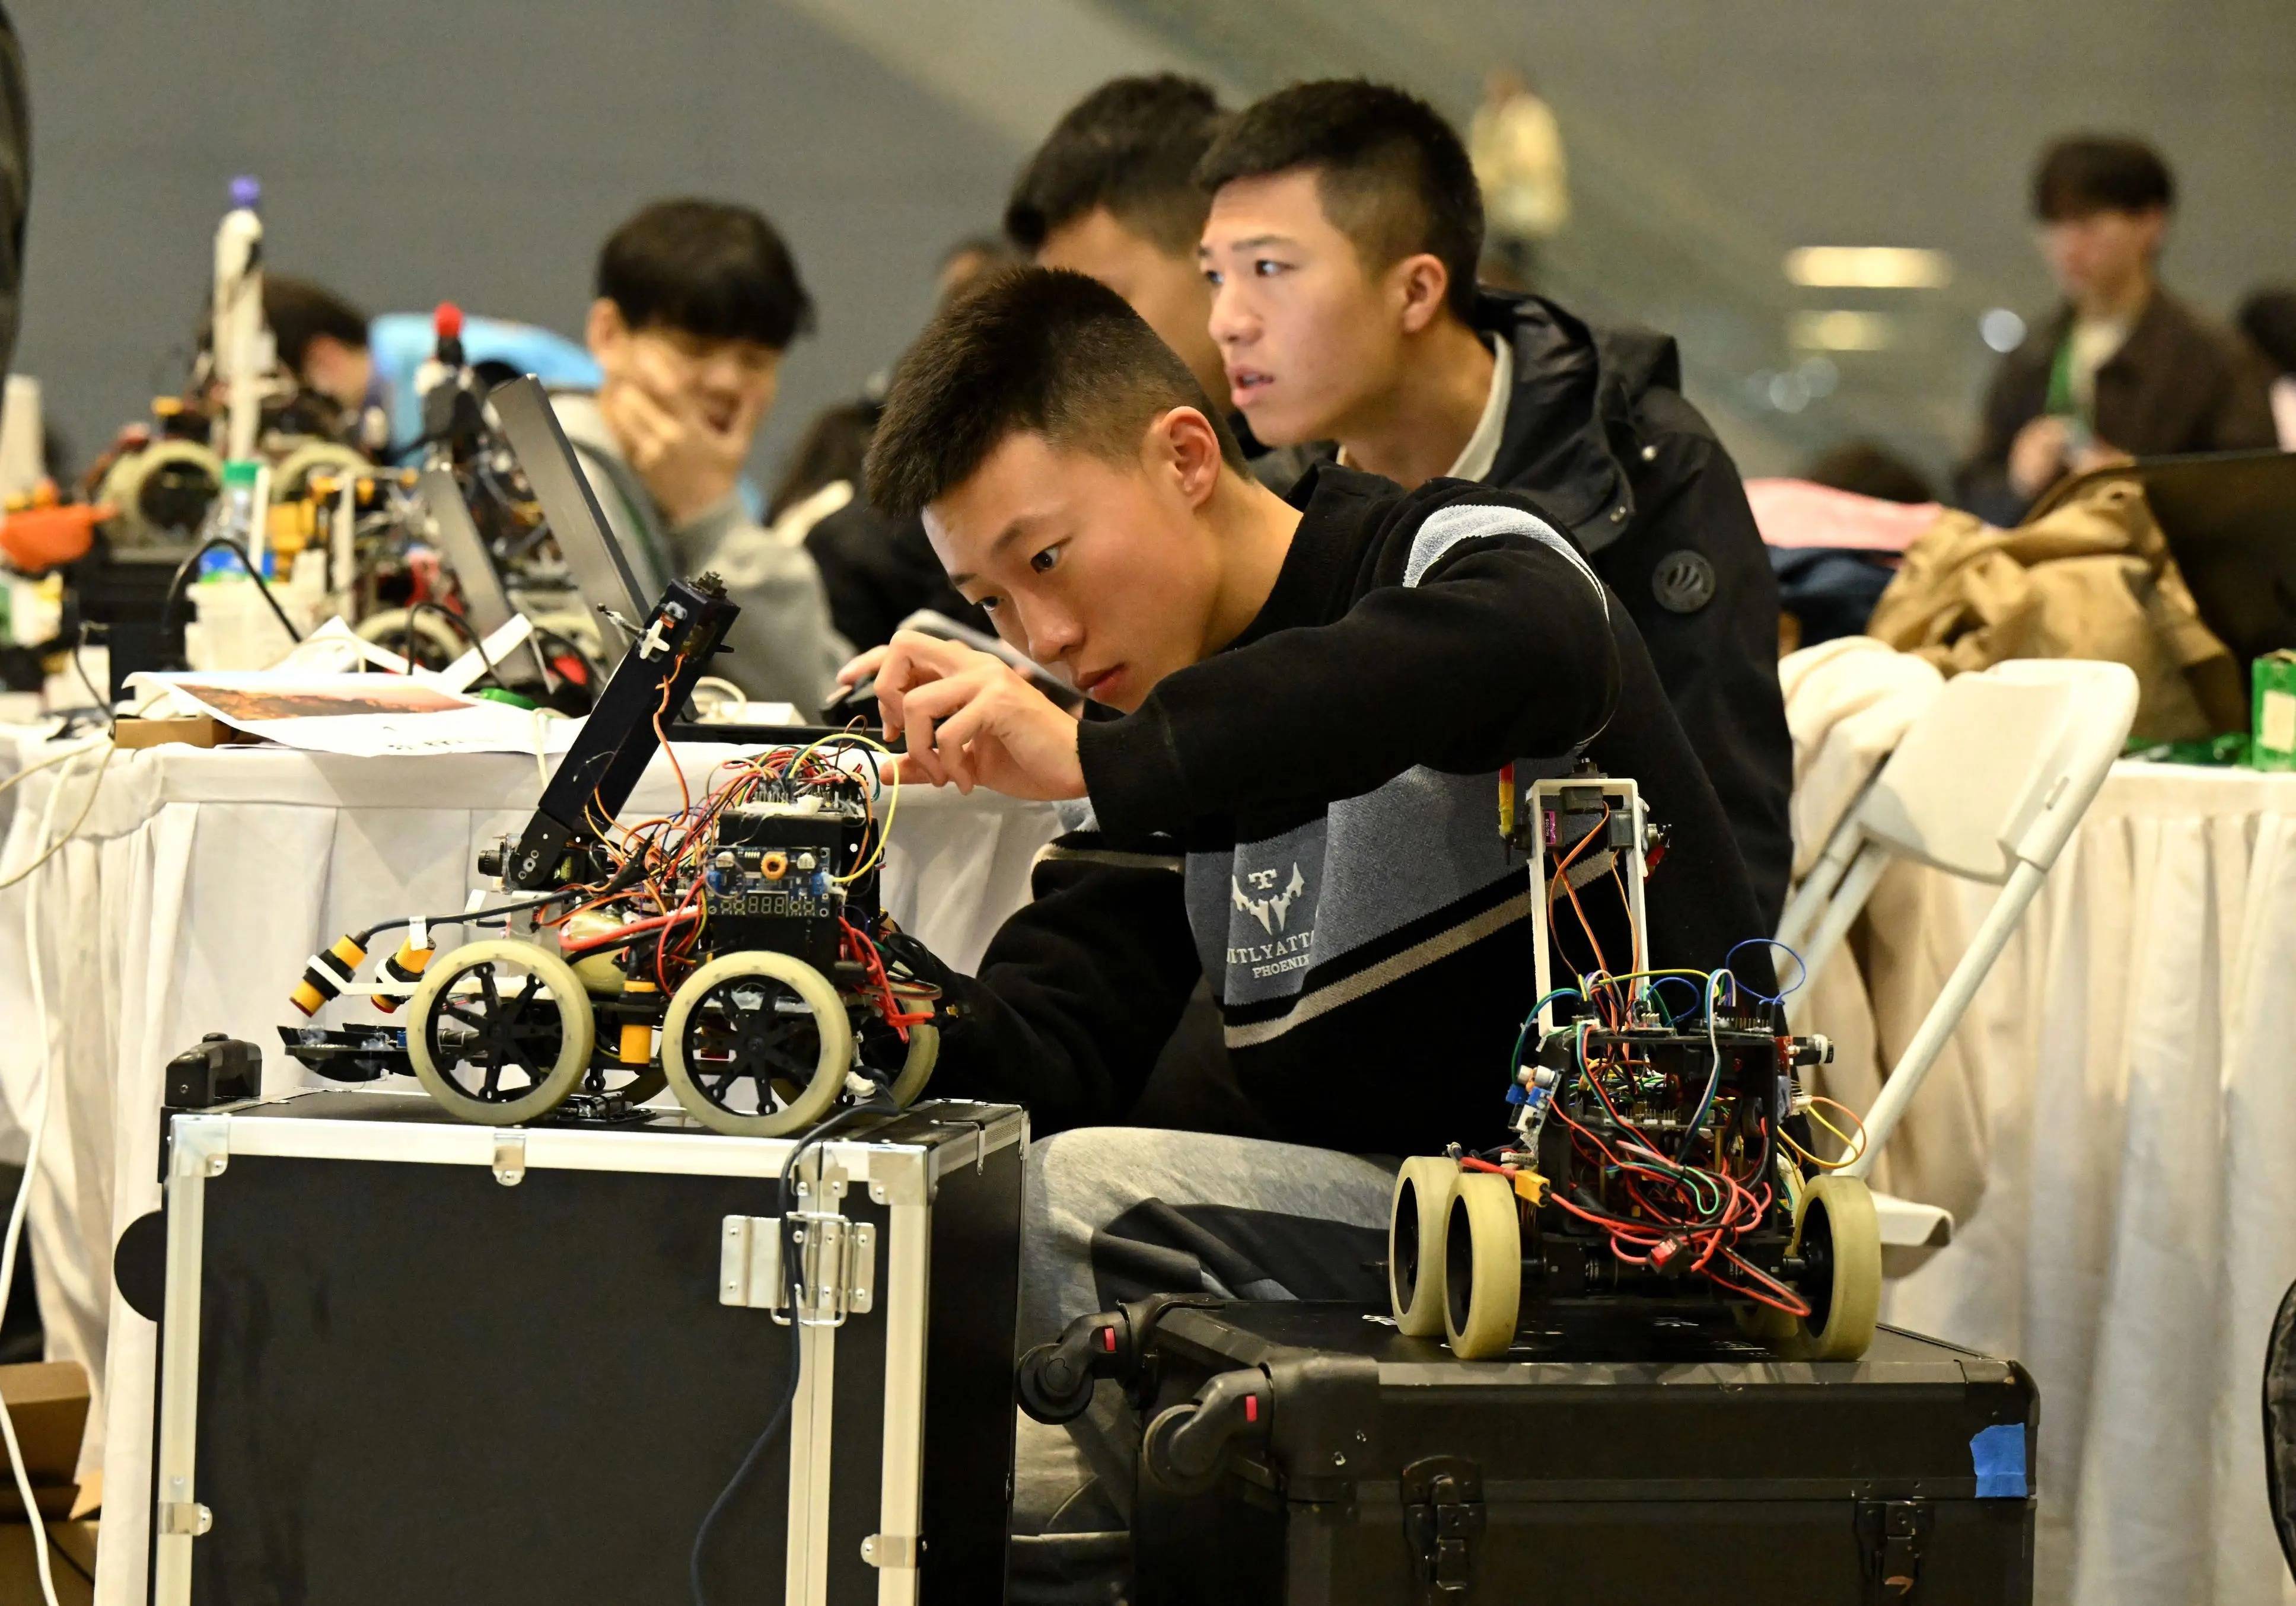
它的秘密藏在“内外双循环”里。内层Agent管干活:看、算、动;外层Agent管反思:汇总失败录像、猜原因、写个小补丁、跑个快速验证、靠谱就存进共享知识栈。整个过程没人按暂停键,也不重启训练框架。这不是“打补丁”,是让机器人长出了自己的“科研习惯”——发现问题→提假设→做实验→改策略。LIBERO-Pro Long测试里,它在位置扰动下成功率达28%,比英伟达ASPIRE高5.8个百分点;更关键的是,任务越长、组合越复杂,优势越明显。三任务平均成功率66.7%,甩开基线方案整整40个百分点。
有人问:这算AGI起步吗?还早。但它踩准了当前最痛的点:AI不是不会,是学不会“举一反三”。实验室训得好好的,换张桌子、换句指令就懵。Recursia不追求一步封神,而是让机器人学会“带脑子上岗”——失败不是终点,是下一次成功的输入。就像人学骑车,摔了不是删掉记忆重来,而是悄悄调整重心和蹬踏节奏。这篇工作没吹“颠覆”,但把RSI(递归自我改进)从论文里的哲学概念,拧进了真实机械臂的关节控制代码里。它不喊口号,只默默把碗放稳了,再把杯子放进那个动过的碗里。
天顺优配提示:文章来自网络,不代表本站观点。